13. 先认识 300 个对象和两台宿主机
13.1 两台机器的职责
192.168.0.5(.5)
  源码、Git、Gitea、ClickHouse、MinIO

192.168.0.2(.2)
  Docker、veth、network namespace、eBPF、AF_XDP、控制器、前端
源码只通过 Git 同步。.5 不运行 300 节点仿真;.2 是唯一大型仿真和部署宿主机。
13.2 三类仿真对象
| ID | 数量 | 类型 | 网络角色 |
|---|---|---|---|
| 1..200 | 200 | satellite(卫星) | 网络节点,运行转发、控制代理和按 profile 部署的算子 |
| 201..250 | 50 | aircraft(飞机) | 端侧,只选接入卫星并产生/接收普通业务 |
| 251..300 | 50 | ship(船舶) | 端侧,与飞机使用相同端侧协议 |
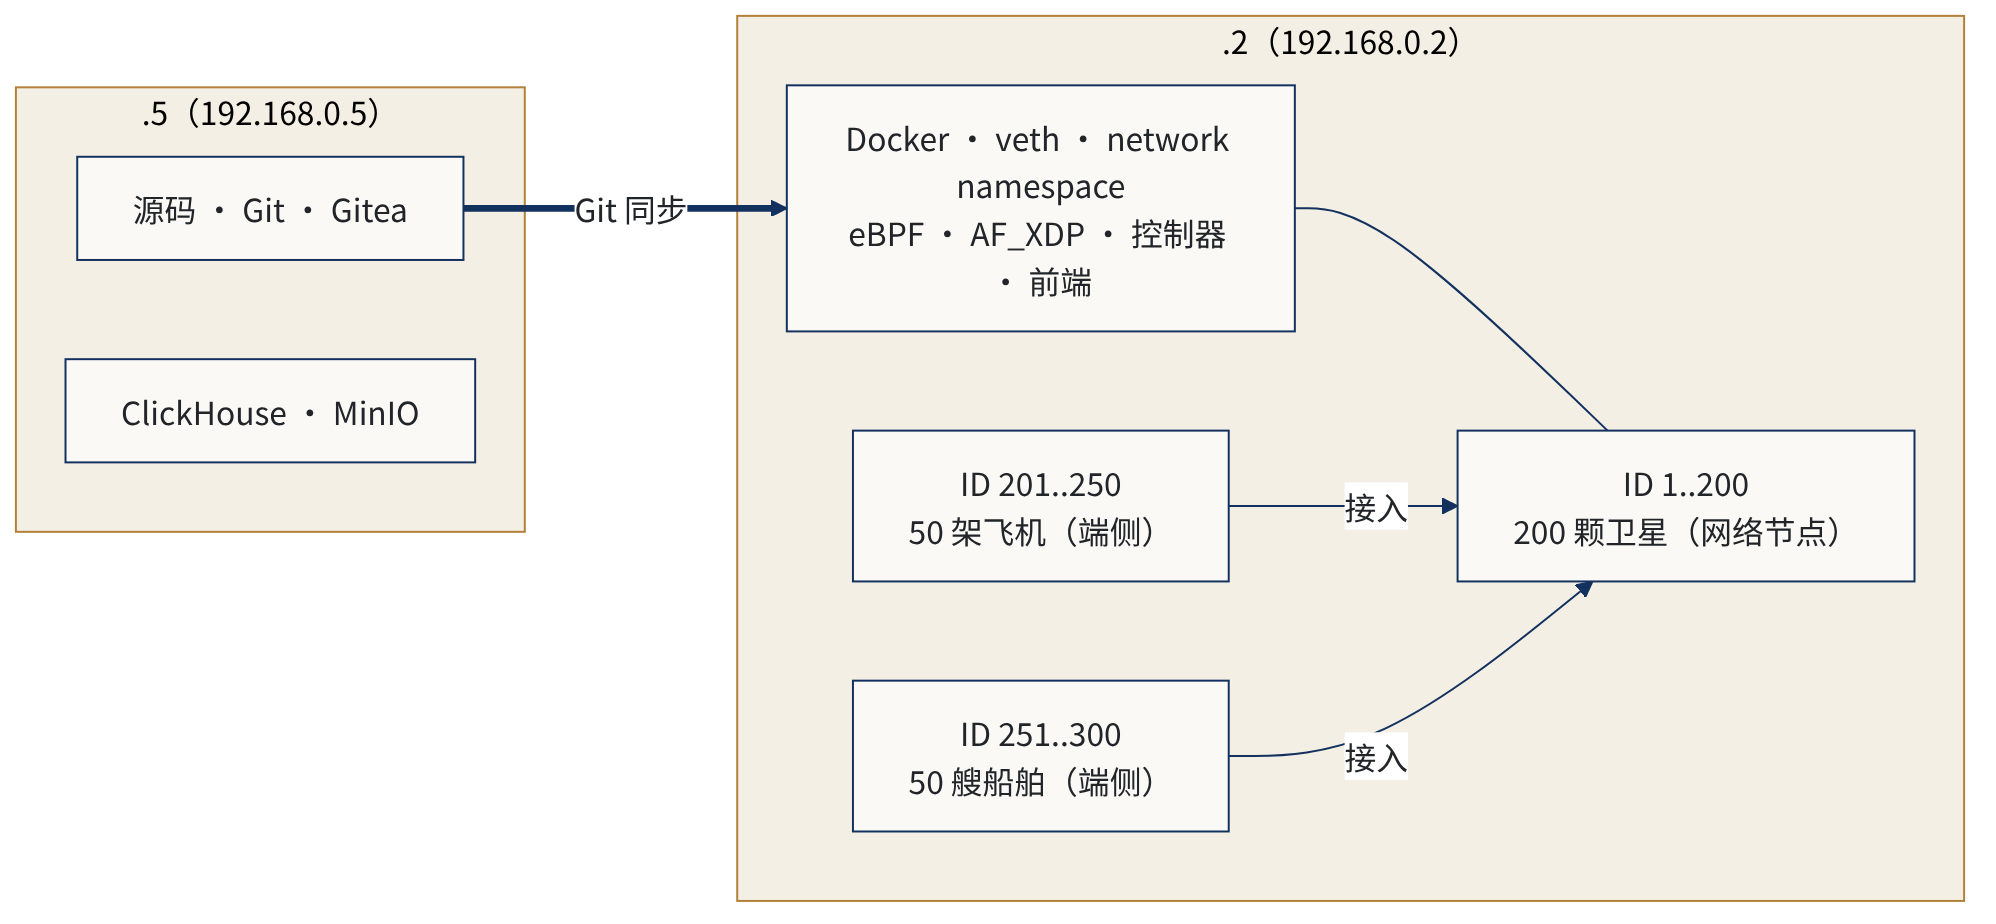
图 1 两台宿主机分工与三类仿真对象:.2 是唯一的大型仿真宿主机,源码只通过 Git 同步
端侧不是核心中继,不运行 HEFT、全网 FIB 或图像算子。飞机和船舶的不同主要属于物理场景和前端类型,不形成不同的任务协议。
13.3 地址空间
| 地址 | 含义 | 示例 |
|---|---|---|
fd42:1::<node> | 网络节点普通 IPv6 | 节点 10 为 fd42:1::a |
fd42:2::<node> | 物理节点/集成端侧交付 SID | 节点 10 为 fd42:2::a |
fd42:3:<node>::<function> | 具体算子实例 SID | gray@10 为 fd42:3:a::100 |
fd42:4:<node>::6:<endpoint> | 独立端侧 IPv6 交付 SID | endpoint300@199 为 fd42:4:c7::6:12c |
fd42:7::<function> | 逻辑 Anycast 算子 SID | gray 为 fd42:7::100 |
fd42:10:<endpoint>::2 | 端点业务 IPv6 | endpoint300 为 fd42:10:12c::2 |
fd42:197::/32 | 物理 uSID locator | 16-bit 指令 container |
同一个数字 ID 在地址的不同位置代表不同命名空间。不能因为尾数相同就把普通节点地址、SID 和端点服务地址混为一谈。
14. Container、Namespace 和 veth
14.1 Docker Container
Container(容器)是由 Linux namespace 和 cgroup 等机制隔离的一组进程。Docker 是
创建和管理容器的工具,不是一个独立内核。300 节点共享 .2 宿主机内核,但看到隔离的进程、网络接口和文件系统视图。
cgroup(control group,控制组)用于统计和限制进程资源;本项目可以观察容器 CPU 和内存,但不能把观察器输出当作协议就绪条件。
14.2 Network Namespace
Network Namespace(网络命名空间)提供独立的接口、地址、路由、邻居和网络协议 栈。每个网络节点容器有主 namespace;每个实际部署的算子又有自己的子 namespace。
这样 gray@10 不是节点 10 主进程里的一个普通函数,而是拥有:
- 自己的 IPv6/SRv6 状态;
- 自己的具体 SID 与 End.X;
- 自己的 XDP/AF_XDP 算子接口;
- 自己的常驻用户态算子进程。
14.3 veth
veth(virtual Ethernet pair,虚拟以太网对)像一根虚拟网线的两端:从一端写入 的 Ethernet 帧从另一端出现。
本项目主要用 veth 连接:
- 宿主机与节点容器物理接口;
- 节点主 namespace 与算子 namespace;
- 算子内核侧接口与 AF_XDP 侧接口;
- 网络节点与集成端侧 namespace;
- 节点与控制器的独立控制附件。
链路质量不由 veth 本身模拟,而由宿主机 AF_XDP fabric 实施。
15. XDP、eBPF 和 AF_XDP
15.1 eBPF
eBPF(extended Berkeley Packet Filter,扩展伯克利包过滤器)是一种在 Linux 内核受验证执行环境中运行小程序的技术。程序加载前经过 verifier(验证器),不能像普通用户程序一样任意访问内存。
eBPF map(映射)是内核和用户态共享的键值数据结构。例如,宿主 XDP 入口用 map 保存:
key   = Linux interface index
value = source node ID
另一类 map 可保存 AF_XDP socket。任务分类 map 属于第四编,在 task 和 Color 定义以后再讲。
15.2 XDP
XDP(eXpress Data Path,快速数据路径)是 Linux 网络栈很早的包处理 hook(挂载点)。 它可以快速执行 pass、drop、redirect 等动作。
宿主 fabric 的 XDP 程序只做 L2 redirect:根据目标 MAC 把帧送到代表源节点端口的 AF_XDP socket。它不计算路由,不解释应用层数据,也不执行图片算子。
15.3 AF_XDP
AF_XDP(Address Family XDP,XDP 地址族套接字)让用户态程序通过共享内存 ring 高效收发 XDP 重定向的帧。
关键概念:
- UMEM(User Memory,用户内存区):内核与用户态共享的 packet frame 池;
- Ring(环形队列):生产者和消费者交换 descriptor(描述符)的有界队列;
- RX ring:用户态接收包;
- TX ring:用户态发送包;
- fill ring:把可用 frame 交给内核;
- completion ring:内核归还已发送 frame。
有界 ring 是系统真实容量,不应通过无限缓存掩盖拥塞。所有权错误会导致 frame 重复使用、数据破坏或 EINVAL,所以代码显式统计 UMEM ownership errors。
15.4 Host Link Fabric
Fabric(交换/链路编织层)在本项目中是宿主机 AF_XDP 用户态进程。它为每条有向边 维护:
- connected:是否连通;
- rate_bps:当前 bit/s 速率;
- design_rate_bps:设计基线速率;
- burst_bytes:令牌桶可突发字节;
- queue_bytes:有限出口队列;
- delay_us:传播时延。
Token Bucket(令牌桶)按速率产生 token(令牌),发送字节消耗 token;允许有限
burst 但长期平均速率受限。Propagation Queue(传播队列)保存已经发送、尚未到达的帧直到 delay_us 到期。
15.5 三类丢包必须分开
| 计数 | 含义 |
|---|---|
connectivity_drops | 链路当前断开,包无法进入该边 |
egress_congestion_drops | 有限出口队列满,真实拥塞丢包 |
propagation_drops | 已进入传播阶段后丢失;当前合同应恒为 0 |
不能把三类都写成“网络丢包”。它们对应完全不同的组件边界。
15.6 为什么不用 bridge、qdisc 模拟链路
Bridge(网桥)会在二层学习和转发,qdisc(queueing discipline,排队规则) 由 Linux 流量控制框架实施排队/限速。本项目不使用 Linux bridge、TC qdisc 或网络命名空间中的特殊链路模拟,因为这会把物理模型分散在多个内核机制里,难以形成统一、可审计的有向链路统计。
其他 eBPF classifier 可以设置本地 mark,但它们不模拟链路速率、时延或丢包。
15.7 项目里有两类 eBPF,不能混为一谈
本项目至少有两个使用 eBPF 的边界:
- 任务 classifier(分类器)在节点入口读取已经验证的业务身份,查任务 map 并设置
skb->mark。它回答“这个任务应选择哪张本地策略路由表”,具体格式留到第四、七编; - 宿主 fabric XDP 程序在 300 个宿主 veth 入口检查 Ethernet 头,把项目帧 redirect 到AF_XDP socket。它回答“这是谁发出的二层帧,应交给哪个用户态入口队列”。
前者参与 SR Policy 选择,后者只把帧引入物理链路模拟器。宿主 XDP 程序不读取 IPv6、SRH 或任何编排结果与业务语义。把二者都称为“eBPF 转发”会掩盖真正的状态所有者。
15.8 300 个物理端口如何接到宿主
每个节点容器有一对专用 veth:
节点容器内:lfc001 ... lfc300
宿主机一侧:lfh001 ... lfh300
容器从 lfc017 发出的 Ethernet 帧会出现在宿主 lfh017。创建接口时就设置确定性 MAC,而不是等 udev 异步命名或修改;这是为了避免 300 接口并发创建时出现身份竞态。
项目单播 MAC 把 node ID 编码在末尾字节。项目还定义 L2 group MAC(组播组 MAC)承载HELLO 等一跳发现帧。fabric 只接受符合这些项目身份的目的 MAC;与项目无关的帧由 XDP返回 XDP_PASS,继续进入普通 Linux 网络栈。
15.9 XDP 程序逐条做了什么
宿主程序加载 bpf/xdp_link_fabric.bpf.c,并使用两个 eBPF map:
lf_ingress_nodes : host ifindex -> source node ID
lf_node_xsks     : source node ID -> AF_XDP socket FD
ifindex(interface index,接口索引)是 Linux 内核给网络接口分配的整数身份。
XSKMAP是专门保存 AF_XDP socket 引用、供 bpf_redirect_map() 重定向的 map 类型。
可以把 XDP 逻辑近似读成:
if Ethernet头不完整:
    XDP_PASS
if 目的MAC既不是项目节点MAC,也不是项目组MAC:
    XDP_PASS
source = lf_ingress_nodes[收到包的ifindex]
if source不存在:
    XDP_PASS
if 单播目的MAC不能解出合法destination,或destination == source:
    XDP_PASS
return redirect(lf_node_xsks[source])
最容易误解的一点是:XSKMAP 按source(源节点)索引,不是按 destination 索引。XDP只知道“帧从哪一个宿主 veth 进入 fabric”,于是先把它交给该源端口的 RX ring。源到目的是否连通、传播多久、能否排队,都必须由用户态 fabric 执行。若 XDP 直接按目的端口转发,链路规则就被绕过了。
15.10 为什么链路逻辑不全写进 XDP
eBPF verifier 要求程序有可证明的有界执行和安全内存访问。动态的 300×300 有向矩阵、每边有限队列、令牌桶时间推进、传播队列、配置代次切换和完整统计都不适合塞进一次 XDP 调用。
所以分工是:
XDP内核快路径:最小身份检查 + redirect
AF_XDP用户态:链路通断 + 限速 + 排队 + 传播 + 复制 + 统计
Linux节点协议栈:IPv6 + SRv6 + 邻居发现 + 本地FIB
这不是“为了快把所有网络都搬到用户态”,而是把最早的收包入口与需要时间和状态的物理链路模型放到各自适合的执行环境。
15.11 一个 AF_XDP 端口的 UMEM 与四个 ring
当前 fabric 把 XDP program 以 XDP_SKB 模式挂到 veth,并把 AF_XDP socket 以XDP_COPY | XDP_USE_NEED_WAKEUP绑定。这里:
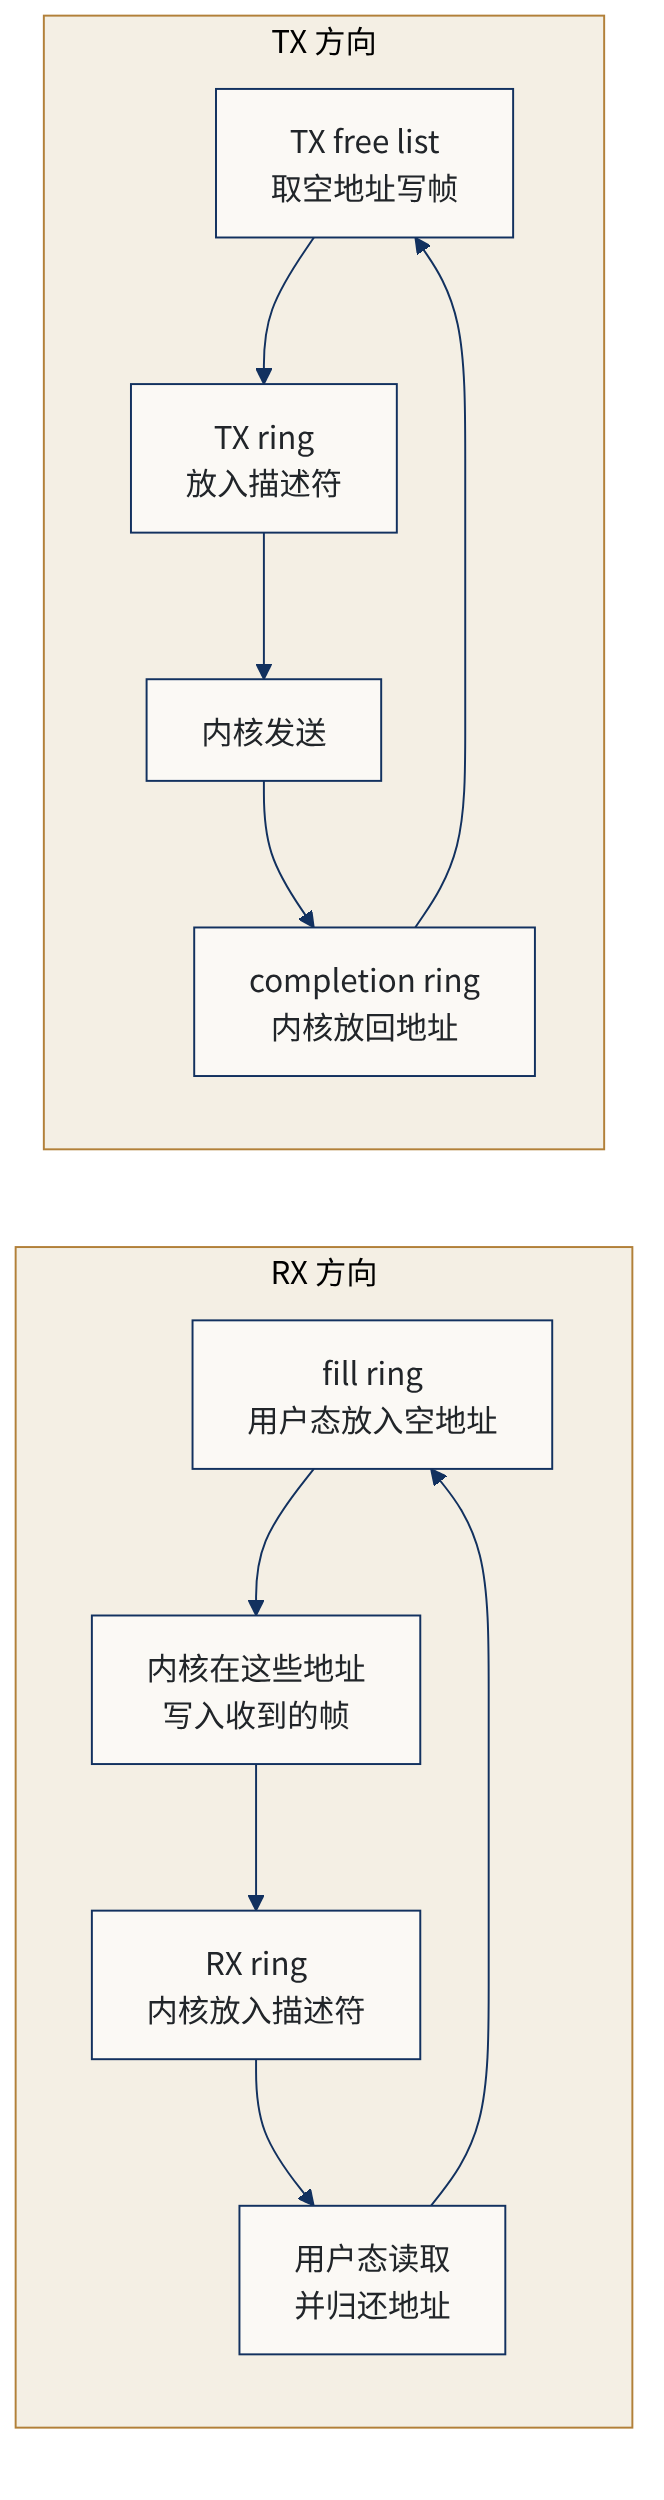
图 2 一个 AF_XDP 端口的 UMEM 与四个 ring 的所有权循环(每端口 4096 × 2048 byte ≈ 8 MiB)
XDP_SKB表示使用内核通用 SKB 路径,兼容 veth;XDP_COPY表示包在内核与 UMEM 之间复制,不假装 veth 支持网卡零拷贝;NEED_WAKEUP表示用户态在内核需要时显式唤醒 TX 处理。
每个端口的当前常量是:
| 项目 | 数量/大小 |
|---|---|
| 单个 UMEM frame | 2048 byte |
| UMEM frame 总数 | 4096 |
| 初始 RX/fill 所有权 | 2048 frames |
| 初始 TX free list | 2048 frames |
| RX/TX/fill/completion ring 容量 | 2048 descriptors |
| 单次 RX 处理上限 | 64 frames |
Descriptor(描述符)不是包本身,而是指出 UMEM 中“地址、长度”等信息的小记录。
四个 ring 的所有权循环是:
RX方向:用户态把空地址放进fill
       -> 内核在这些地址写入收到的帧
       -> 内核把描述符放进RX
       -> 用户态读取并归还地址到fill

TX方向:用户态从TX free list取得空地址并写帧
       -> 把描述符放进TX
       -> 内核发送完成后把地址放进completion
       -> 用户态回收地址到TX free list
一个端口的 UMEM 约为 4096 × 2048 = 8 MiB;300 端口仅 UMEM 就约2.34 GiB,尚未计算 ring、链路矩阵、包副本和进程本身。这说明 300 节点不是把 24 节点脚本复制几遍,而是真实的大规模单机资源工作负载。
15.12 fabric 如何启动 300 个 AF_XDP 端口
scripts/setup_issue_76_physical_fabric.sh 按同一节点规模创建 veth 并启动一个宿主 fabric进程。src/host_link_fabric.c 依次:
- 加载并验证 BPF object(eBPF 目标文件);
- 找到 XDP program 与两个 map;
- 对每个
lfhNNN核对确定性 MAC; - 把 XDP 以 SKB 模式挂到该接口;
- 为节点创建 UMEM、ring 和 AF_XDP socket;
- 写入
ifindex -> node和node -> socket两张 map; - 启动入口线程、链路 worker、配置重载和统计循环。
任何端口身份或 map 绑定错误都不能靠“稍后收包再猜”修复;启动阶段必须失败并报告具体端口。
15.13 RX 线程如何取包并归还 frame
默认有 5 个ingress worker(入口工作线程)。节点按(node_id - 1) % ingress_worker_count 分片,每个线程只 poll 自己负责的 AF_XDP socket。
收到事件后,它最多从 RX ring peek 64 个 descriptor。对每帧执行:
- 验证长度和 Ethernet 目的身份;
- 把帧内容复制到 fabric 自己的
lf_packet; - 解析单播目的 node ID,或识别一跳 group 帧;
- 把内部包交给负责目标端口的链路 worker;
- release 原 RX descriptor;
- 把原 UMEM 地址重新放入源端口 fill ring。
这里有一次有意的 copy。它让源 RX frame 在入口处理完就能归还,而不必被某条可能等待数十毫秒的传播队列长期占用。
15.14 单播与 group 帧的用户态转发
单播帧从 MAC 解出一个 destination,只进入 source -> destination 这一条有向边。
group 帧不能被无条件广播给 299 个节点。fabric 查看当前活动链路矩阵,只向 source 当前
connected 的出邻居各复制一份。于是节点 17 的 HELLO 只会到达物理上连通的邻居;没有
当前邻居时记录 group-no-neighbor,而不是制造一个全网广播域。
这一步是物理发现能够“自然而然发生”的基础:节点协议只发送普通一跳组帧,不读取场景数据库;谁真正收到由这一时刻的物理 fabric 决定。
15.15 为什么还要第二组 worker
默认另有 5 个 link worker。destination 按(destination - 1) % link_worker_count 分片。每个 ingress worker 到每个 link worker 之间有一条固定的SPSC ring(Single Producer Single Consumer,单生产者单消费者环),容量 8192;eventfd 用于从空闲状态唤醒消费者。
按 destination 分片的实用意义是:同一个目标 AF_XDP TX 端口只由一个 link worker 拥有,避免多个线程同时修改 TX ring 和 TX free list。每条有向边仍有自己的通断、token 和队列,端口所有权与链路状态所有权因此清晰可审计。
15.16 每条有向链路保存什么状态
对每个 source -> destination,用户态保存:
配置:connected, delay_ns, rate_bps, design_rate_bps,
      burst_bytes, queue_bytes
运行态:egress queue, propagation queue, queued_bytes,
        tokens, last_token_update_ns, counters
内部实现可以为指针队列扩容,但 queued_bytes 绝不能超过配置的 queue_bytes。换句话说,内存容器能扩展不等于模型容量无限;接受还是丢弃由明确的字节上限决定。
15.17 Token Bucket 的公式与例子
经过 Δt 纳秒后新增 token 字节数为:
added_bytes = Δt × rate_bps / (8 × 10^9)
tokens = min(burst_bytes, tokens + added_bytes)
发送长度为 L byte 的帧需要至少 L 个 token。若缺少 M byte,最早还需等待:
wait_ns = M × 8 × 10^9 / rate_bps
例如链路为 1 Mbit/s,当前没有 token,一个 1000-byte 帧至少需要:
1000 × 8 / 1,000,000 = 0.008 s = 8 ms
burst_bytes 允许已经积攒的 token 短时间连续发送,但不能改变长期平均速率。速率为 0 不进入除法;物理配置把它表达为 connected=false。
15.18 从出口队列到传播队列
一个单播包在链路 worker 中经历:
链路断开
  -> connectivity_drops++,释放内部包

链路连通但egress已达queue_bytes
  -> egress_congestion_drops++,释放内部包

已入egress但token不足
  -> 保留并等待,下次可发送时再检查

token足够
  -> 扣除token
  -> release_ns = now + delay_ns
  -> 移到propagation queue

now >= release_ns
  -> 复制到目的端口TX UMEM
  -> 提交TX descriptor
传播时延和发送速率是两个不同阶段。一个 1 Mbit/s、20 ms 传播时延的 1000-byte 帧,在空桶情况下既要等待约 8 ms 取得 token,又要在进入传播队列后等待 20 ms。
15.19 TX 提交、唤醒与 completion
传播到期后,worker 从目的端口TX free list 取得一个 UMEM frame,把 Ethernet 帧复制进去,再向 TX ring 提交 descriptor。若内核提示需要唤醒,程序执行零字节 sendto() 触发发送。
EAGAIN、EBUSY 和 ENOBUFS 表示当前需要稍后重试,并不等于链路协议错误。成功提交也不等于 frame 已经可以复用;只有 completion ring 归还该地址后,用户态才能放回 TX free list。
因此三种对象有严格不同的寿命:
- 源 RX UMEM frame:内容复制后立刻归还源 fill ring;
- fabric 内部 packet 副本:归某条有向边的 egress/propagation 队列所有;
- 目的 TX UMEM frame:归还 completion 以前不能复用。
历史上的 AF_XDP EINVAL 问题,本质就是破坏了这类 descriptor/UMEM 所有权,而不是“网络偶尔慢”。
15.20 新拓扑怎样原子切换到 worker
活动配置文件不是逐行在线修改。场景消费者先写同目录临时文件,flush + fsync 后执行os.replace(),让读者看到的要么是完整旧文件,要么是完整新文件。
fabric 解析新文件到另一份堆上矩阵,校验代次与全部字段后才短暂锁住 link workers 并发布整份矩阵。使用 heap(堆)而不是 thread stack(线程栈),是因为 300×300 配置约占数 MiB,不适合放进默认线程栈。
发布时:
- 新关闭的边清除 egress 与 propagation 包,并统一计入
connectivity_drops; - rate/burst 变化时重置或钳制 token,不能继承超出新上限的信用;
- fabric generation 递增,并记录对应 physical scenario generation;
- SIGHUP 只用于加速同一套文件检查,不提供另一条旁路配置机制;
- state 文件写出准确已应用代次和重载耗时,供上游等待 ACK。
已经进入传播阶段的包正常不会随机丢失,所以合同中的 propagation_drops 恒为 0;若传播中链路被新代关闭,丢失原因仍是 connectivity change(连通性变化),不能换个名字隐藏。
15.21 一个 SRv6 帧穿过 AF_XDP fabric 的完整轨迹
以节点 17 向节点 18 发送已经带 SRH 的 IPv6 帧为例:
节点17 Linux FIB/邻居表选出节点18 MAC
  -> lfc017发送Ethernet帧
  -> 帧到达宿主lfh017
  -> XDP从ifindex认出source=17
  -> XDP校验目的MAC并redirect到XSK[17]
  -> ingress worker复制帧、归还17的RX frame
  -> 解析destination=18
  -> 交给拥有目的18端口的link worker
  -> 查询17->18的connected/rate/queue/delay
  -> 经过令牌桶和传播队列
  -> 复制到18的TX UMEM并提交
  -> 帧从宿主lfh018进入容器lfc018
  -> 节点18 Linux IPv6/SRv6继续处理active segment
  -> completion归还18的TX frame
fabric 只看二层目的身份和有向边状态。帧里究竟是普通 IPv6、SRH、HELLO 还是应用数据,不改变上述物理过程;只有书中第八编所述三级降档是用户态 fabric 的一个明确、受限业务例外。
15.22 规模、限制与排错顺序
实现为 300×300 有向矩阵分配索引,便于 O(1)查询,但真正配置的连通边是稀疏的。不能看到矩阵容量就误认为每颗卫星与 299 个对象直连。
遇到“节点 A 收不到节点 B”时按边界检查:
- A 的 Linux 是否真的发出了目的 MAC 正确的帧;
- A 对应 XDP 是否挂载,两个 map 是否包含 A;
- A 的 RX ring 是否收到,是否有 invalid descriptor/fill empty;
A -> B当前是否 connected;- 是 connectivity drop、egress congestion 还是 token wait;
- 包是否到达 propagation release 时间;
- B 的 TX ring 是否 busy,completion 是否正常回收;
- B 的 Linux 协议栈是否接收并按 IPv6/SRv6 处理。
只有先找到第一处事实中断,才能决定修改 XDP、UMEM 所有权、链路模型还是节点协议。
16. 物理场景怎样变成真实链路
16.1 先区分运动模型、物理图和协议图
这一章涉及三层对象:
运动模型:在时间t计算300个对象的位置
物理链路图:按几何与环境规则决定哪些有向边真的能传帧
协议拓扑图:节点用实际HELLO/ACK观察后形成的双向邻接
运动模型不安装路由,物理图不向节点注入邻居,控制器也不修改物理图。三层通过真实帧传递因果关系,避免“场景脚本知道答案,于是直接把正确答案写进 FIB”。
16.2 当前是确定性圆轨道工程模型,不是 SGP4
scripts/physical_scene_provider.py 实现的是deterministic circular-orbit engineering model(确定性圆轨道工程模型)。它用于生成可重复、连续运动且几何自洽的研究场景,不是读取真实 TLE 并用 SGP4 计算的精密星历。
- Ephemeris(星历):天体或航天器随时间的位置/速度数据;
- TLE(Two-Line Element,两行轨道根数):公开卫星常见的轨道参数格式;
- SGP4(Simplified General Perturbations 4,简化常规摄动模型 4):用 TLE 传播近地轨道的工程算法;
- Deterministic(确定性):相同配置、seed 和仿真时刻必得相同结果。
教材必须明确这个边界:当前场景能验证动态网络协议与计算编排,不能拿来声称某颗真实卫星在某个 UTC 时刻的精密位置。
16.3 300 个对象的基础配置
当前 configs/issue255-physical-scene-300.json 定义:
| 对象/参数 | 当前值 |
|---|---|
| 轨道面总数 | 20 |
| 每轨道面卫星 | 10 |
| 卫星总数 | 200 |
| 极轨轨道面 | 前 10 面,倾角 90°,高度 550 km |
| 倾斜轨道面 | 后 10 面,倾角 53°,高度 600 km |
| 飞机 | 50,高度约 10–12 km,基准速度 240 m/s |
| 船舶 | 50,高度 1 m,基准速度 12 m/s |
| 星间/接入设计速率 | 1 Mbit/s |
| 端侧最低仰角 | 5° |
| 跨轨候选最大距离 | 5500 km |
卫星 ID 由位置确定:
satellite_id = plane × satellites_per_plane + slot + 1
因此 plane 0 的 slot 0..9 是节点 1..10,plane 19 的 slot 0..9 是 191..200。飞机为 201..250,船舶为 251..300。
16.4 计算卫星圆轨道速度和周期
设:
R为地球半径,当前取 6,371,000 m;h为轨道高度;r = R + h为地心到卫星的轨道半径;μ = 3.986004418 × 10^14 m³/s²为地球标准引力参数;ω为轨道角速度,单位 rad/s;v为轨道线速度;T为一周周期。
圆轨道模型使用:
ω = sqrt(μ / r³)
v = sqrt(μ / r)
T = 2π / ω
代入当前配置:
| 高度 | 轨道半径 | 角速度 | 线速度 | 周期 |
|---|---|---|---|---|
| 550 km | 6,921 km | 0.00109652 rad/s | 7,588.998 m/s | 5,730.127 s(95.502 min) |
| 600 km | 6,971 km | 0.00108474 rad/s | 7,561.733 m/s | 5,792.334 s(96.539 min) |
这解释了为什么一个 60 分钟 Run 中卫星已经移动很远,却还没有完成一整圈。
16.5 从 plane/slot 得到轨道相位
每颗卫星的相位由 slot、轨道面错相和时间共同决定,可概括为:
phase(t) = 2π × slot / slots
         + 2π × local_plane / (group_planes × slots)
         + inclined_phase_offset
         + ωt
RAAN(Right Ascension of the Ascending Node,升交点赤经)描述轨道平面绕地球自转轴
的方位。当前极轨组的 RAAN 分布在 π 范围,倾斜组分布在 2π 范围;相邻面再加小的phase 错开,避免所有卫星在同一经线同步重合。
给定 RAAN Ω、相位 u、倾角 i 和半径 r,代码先计算惯性坐标:
x = r(cosΩ cosu - sinΩ sinu cosi)
y = r(sinΩ cosu + cosΩ sinu cosi)
z = r(sinu sini)
16.6 ECI、ECEF、经纬度分别是什么
上式得到类似ECI(Earth-Centered Inertial,地心惯性坐标)的位置,它不随地球表面一起转。前端和地面对象需要ECEF(Earth-Centered Earth-Fixed,地心地固坐标):坐标轴随地球旋转,相同经纬度的地面点在 ECEF 中近似固定。
地球自转角速度取 7.2921159 × 10^-5 rad/s。在时刻 t,代码绕 z 轴变换:
θ = earth_rotation_rate × t
x_ecef =  cosθ × x_eci + sinθ × y_eci
y_ecef = -sinθ × x_eci + cosθ × y_eci
z_ecef = z_eci
然后从 ECEF 向量得到 latitude(纬度)、longitude(经度)和 altitude(高度)。heading(航向)通过比较 t 与 t+0.25 s 的位置估算。这样前端看到的是地球自转背景下连续移动的卫星,而不是轨道平面上的静态点。
16.7 飞机和船舶如何移动
飞机和船舶不是随机游走。provider 按对象 index 确定性生成初始纬度、经度和 heading,再用
great-circle motion(大圆航行)沿球面推进:路程等于 speed × elapsed_time。
当前速度在基准值附近按 index 做小幅、可重复的变化;飞机高度在 10–12 km 间分布,船舶高度为 1 m。相同配置和仿真时间永远产生相同位置,所以测试可以复现;运动又只依赖物理参数,不依赖任务是否成功。
16.8 怎样判断两颗卫星之间没有被地球挡住
仅看两星距离不够。即便相距不远,它们连线也可能穿过地球。代码对两端 ECEF 向量 a、b 计算线段上离地心最近的点:
p(q) = a + q(b-a), 0 <= q <= 1
q* = clamp(-a·(b-a) / |b-a|², 0, 1)
closest = p(q*)
若 |closest| < EarthRadius,线段穿过地球,LOS(Line of Sight,视距)不成立;否则才有几何视距。跨轨候选还必须满足距离不超过 5500 km。
这条规则来自几何,不知道业务、HEFT 或某项验收指标,所以链路通断是场景自然演化的结果。
16.9 同轨链路和跨轨链路怎样选
每颗卫星固定考虑同一轨道面的前后两个 slot,轨道首尾相接形成 ring(环):
plane p: slot0 -- slot1 -- ... -- slot9 -- slot0
这给每颗健康卫星两个 intra-plane(同轨)端口。
跨轨不能把所有满足 LOS 的候选都连起来,否则一颗卫星会瞬间拥有几十条“天线”。代码先列出不同轨道面的合法候选及距离,再做reciprocal nearest-first matching(互惠最近优先匹配),并用 augmenting-path repair(增广路径修复)尽量让每颗卫星获得两个 cross-plane(跨轨)端口。匹配是全局确定性的,但输入完全来自这一时刻的几何候选。
在当前正常配置且候选充分时,一颗卫星的基础度数约为:
2条同轨边 + 2条跨轨边 = 4个星间邻居
“候选很多”与“实际端口很多”因此是两回事。
16.10 飞机/船舶怎样得到一条实际接入边
端侧到卫星的elevation(仰角)是视线相对本地水平面的角度。设端侧 ECEF 为 e,卫星为 s,视线为 s-e,本地天顶方向为 e/|e|。代码用点积求仰角,仅保留至少 5°的卫星,排除已损毁卫星,然后选择距离最近者。
provider 为每个端侧至多生成一条当前物理接入关系。这不是把“endpoint 233 属于卫星 17”写进控制器;它只是决定此时哪条无线物理边能送达 Ethernet 帧。端侧与接入节点仍必须通过真实 HELLO/ACK 形成观察,handover 也必须由旧帧收不到、新帧实际收到自然发生。
16.11 无向关系为什么写成两条有向边
几何上选出的是一对节点,但 fabric 按有向边执行,因此每个关系展开为:
A -> B
B -> A
当前两方向使用相同几何距离和基础速率,但各自拥有独立 token、队列和统计。传播时延按光速估算:
delay_us = max(1, ceil(distance_m / 299,792,458 × 10^6))
例如 3000 km 的真空几何传播时延约为 10,007 us。该数只描述传播,不包含令牌等待、排队、Linux 调度、算子计算或控制面收敛。
16.12 环境输入、降速和断链
环境输入只能按明确的无向节点对影响链路,并带生效仿真时刻。rate_ratio_milli 以千分比表达:
1000 -> 恢复设计速率,移除override
800  -> 当前速率为设计速率的80%
400  -> 当前速率为设计速率的40%
0    -> connected=false
design_rate_bps 保留基线,rate_bps 保存当前有效值。物理干扰不应偷偷修改任务、算子或路由答案;它只改变链路事实,之后影响由协议和业务自然传播。
16.13 10% 节点损毁到底怎样发生
正式森林火灾场景使用 200 颗卫星中的固定 20 颗,即 10%。当前 60 秒 epoch 下:
generation 1..10:0 <= t < 600 s,全部卫星健康
generation 11起:t >= 600 s,固定20颗卫星损毁
rotation_per_generation = 0:损毁集合不轮换
20 个 ID 通过 SHA-256(seed, generation, action, node_id) 的确定性排序选择,只依赖 seed 和物理代次,不读取业务源、目的、路径、算子或结果。损毁使所有关联数据边和该节点控制附件断开,但容器和协议进程继续存在。于是实验比较的是“从 100% 节点健康的成功率 A 自然下降到90% 节点健康的成功率 B”,而不是事先挑一组恰好不影响业务的故障。
16.14 Scene frame 与 Topology Generation
Scene frame(场景帧)用于前端按当前 elapsed time 展示连续位置; physical topology generation(物理拓扑代次)是在完整时间槽内有效的链路快照。
当前 epoch 为 60 秒。generation g 对应:
simulation_time = (g - 1) × 60 s
[valid_from_ns, valid_until_ns)
前端可以更频繁采样位置,但链路线条必须来自当前已提交 generation,不能用画面插值临时发明一条数据面不存在的边。
16.15 为什么只准备 current 和 next
scripts/topology_scene_runtime.py 以 monotonic clock(单调时钟)为仿真时间源,根据(now-origin)/epoch 推导 current generation,并只缓存 current 与 next。这样既能在边界前准备下一代,又不会一次生成一小时的未来答案。
runtime 记录 Linux boot ID;若 SQLite 文件来自另一轮宿主启动,则拒绝把旧单调时钟坐标当作当前事实。未来代次也不能越过 next 无限 look-ahead(前视),防止观察未来。
16.16 一份物理快照里有什么
每份完整 snapshot 至少包含:
schema
generation
valid_from_ns / valid_until_ns
node_count
provider名称、模型版本和参数
damaged_node_ids
全部有向link:source, destination, kind, connected,
              delay_us, rate_bps, design_rate_bps
快照内容计算 SHA-256 digest(摘要)。同一 generation 若再次出现不同 digest 会被拒绝,防止“版本号没变但事实偷偷改变”。
16.17 SQLite 事务怎样保证 300 节点只看到完整拓扑
scripts/topology_slot_store.py 使用 SQLite WAL(Write-Ahead Logging,预写日志)和synchronous=FULL。发布过程是:
BEGIN IMMEDIATE取得写事务;- 验证 generation 严格连续;
- 验证前后有效时间连续、node_count 稳定;
- 插入 generation 元数据和全部 link rows;
- 重新核对实际 link count;
- 写入完整 snapshot JSON 与 digest;
COMMIT一次变为可见;任何异常执行 rollback。
因此消费者不会读到“前 100 条边是新代、后 400 条边还是旧代”的半份拓扑。SQLite 只位于低频控制路径,不在 AF_XDP 逐包热路径。
16.18 物理快照怎样变成 AF_XDP 活动矩阵
scripts/topology_slot_fabric.py 严格等待下一代,不允许跳号。在 current 的valid_until_ns 到达时:
读取next不可变snapshot
  -> topology_snapshot_to_fabric.py生成文本矩阵
  -> 同目录临时文件flush + fsync
  -> os.replace原子替换活动配置
  -> 向fabric发送SIGHUP加速检查
  -> fabric解析并发布完整内存矩阵
  -> 等待state文件确认exact scenario generation已应用
  -> 记录reload duration和应用结果
fabric 配置每行表达一条有向边:
source destination connected delay_us rate_bps design_rate_bps
burst_bytes queue_bytes
没有出现在稀疏配置里的矩阵项保持断开。AF_XDP worker 随后只查询已发布的内存状态,绝不为每个包访问 SQLite。
16.19 物理拓扑不会直接通知路由协议
这是整个系统最重要的自然性规则:
错误做法:scene计算A-B断开 -> 直接告诉controller删边 -> 直接改节点FIB

当前做法:scene关闭AF_XDP中的A-B
       -> A/B真实HELLO或ACK无法通过
       -> 节点自己的miss/RTO达到失败条件
       -> 节点上报自己观察到的LINK_DELTA
       -> controller只组合节点事实
       -> 各节点收到新图后本地重算FIB
反方向恢复同理:打开物理边不等于邻居立即恢复,必须等新的真实 HELLO/ACK 通过。
16.20 HELLO/ACK wire 与自适应超时
邻居协议定义在 scripts/neighbor_hello_wire.py:magic 为 NHLO,版本 2,HELLO kind 为 1,ACK kind 为 2。33-byte wire message 携带 sender、role、进程 instance、sequence、请求方instance、发送时间戳和 CRC32。
节点当前默认每 1000 ms 发送 HELLO,策略以 3 次未确认探测判 down。它还维护:
- SRTT(Smoothed Round-Trip Time,平滑往返时延);
- RTTVAR(RTT Variation,往返时延波动估计);
- RTO(Retransmission Timeout,重传超时)。
近似更新为:
RTTVAR <- 0.75 × old_RTTVAR + 0.25 × |SRTT - RTT_sample|
SRTT   <- 0.875 × old_SRTT   + 0.125 × RTT_sample
RTO    <- SRTT + max(clock_granularity, 4 × RTTVAR)
RTO 被限制在合理上下界。peer 进程 instance 变化表示对端重启;故障前的延迟旧 ACK 不能在故障后错误恢复邻居。HELLO 线程独立于控制上报、FIB 安装和日志,某个观察器慢不能停止探测。
16.21 节点怎样把局部邻居变成控制器协议图
节点先发送一次完整 STATE_DIGEST 作为 baseline(基线),之后即时发送 LINK_DELTA 并低频发送完整 anti-entropy snapshot(反熵快照)。delta 不能凭空创建一个从未建立 baseline 的节点行。
控制器 TopologyStore 保存“每个节点声称看见谁”。只有:
A reports B AND B reports A
边 A-B 才进入 confirmed graph。单向报告留在 diagnostics(诊断信息)里,不进入可路由图。某些节点尚未上报不阻塞其他节点形成 partial graph(部分图);图内容不变时也不会无意义地增加代次。
16.22 物理 generation 和控制 generation 不是一个数字
必须区分:
| 代次 | 谁拥有 | 何时变化 |
|---|---|---|
| physical scenario generation | scene/slot/fabric 链 | 每个 60 秒物理时槽严格递增 |
| controller topology generation | TopologyStore | 双向确认的协议图内容实际变化时递增 |
物理 generation 11 关闭 20 个节点后,不会神奇地产生“控制拓扑 generation 11”。不同邻居按各自 HELLO/RTO 时间发现,控制图可能经历多次自然变化。日志必须同时记录各自身份,不能仅写一个含糊的 generation 后强行对齐。
16.23 控制器怎样把图送给 200 个卫星节点
access 服务把 confirmed graph 编码为稀疏、对称的完整 snapshot,并向已注册的 200 个网络节点各发一份。每个节点有独立 pending ACK 状态:
- 最新完整 snapshot 取代该目标尚未确认的旧 snapshot;
- 不为同一慢节点无限累计历史 wire datagram;
EAGAIN只留下该目标的 latest pending 状态;- 每秒重试尚未 ACK 的最新拓扑;
- 一个节点控制 socket 慢,不阻塞其他 199 个节点。
控制 socket 一次被唤醒时会 drain 所有已就绪 datagram,逐个处理观察,但只发布这一 burst 后最新的图。这里的 latest-only 成立,是因为后一份完整拓扑包含前一份的全部现状;资源报告不是相同语义,不能照抄。
16.24 每个节点怎样只计算自己的 FIB
节点接收完整拓扑后先验证 schema、代次和内容,再交给唯一TopologyRouteWorker。worker 只保留 latest;旧代忽略,同代内容变化拒绝。它区分:
accepted generation:用户态已验证并接受
applied generation:本地Linux FIB已成功安装
calculate_node_routes 不做 200 节点 all-pairs shortest paths(全源最短路)。它从自己做一次BFS,再从每个直接邻居做 BFS,复杂度约为:
O(local_degree × (V + E))
对每个 destination 选择最短 hop 的 primary first hop,并计算满足 LFA 条件的 backup。然后用一次 iproute2 batch 协调四类目的前缀:
fd42:1::<N>/128
fd42:2::<N>/128
fd42:3:<N>::/64
fd42:4:<N>::/64
本地直接邻居 down 时,节点可先切受影响目的的合法 backup 或删除路由,不必等待下一份全局图;全局图随后用于收敛其他节点。
16.25 “300 节点拓扑更新”的完整时间线
以某个 60 秒边界上一条 17-18 跨轨链路消失、17-44 新链路出现为例:
t0之前:generation g的AF_XDP矩阵仍活动
t0:SQLite中完整g+1已经准备好
t0:slot consumer原子发布g+1并等fabric准确ACK
t0之后:17<->18帧被connectivity规则阻断;17<->44帧可通过
随后:17/18各自HELLO超时;17/44交换真实HELLO/ACK
随后:节点发LINK_DELTA;controller检查双向性并形成新协议图
随后:access向200个已注册节点发布最新完整图,各目标独立ACK
随后:每节点单worker计算自己的primary/backup并批量安装本地FIB
最后:节点上报TOPOLOGY_STATUS;控制器可记录全体已应用事件
最后的“全体已应用”只是 observation(观察),不是让业务开始的 global barrier(全局屏障)。在收敛窗口内,不同节点处于不同已应用代次是分布式系统的正常事实。
16.26 当前路由成本的限制
物理链路有几何传播时延和真实速率,但当前控制面只上报二值邻接:
network_cost = hop_count × 1000
所以数据面会真实经历每跳 delay_us、令牌等待和排队,规划器却仍按跳数选择。不要把delay_us 已经存在误读为路由一定选传播时延最短路径;加入 latency-aware routing 需要新的协议事实与算法设计。
16.27 前端为什么能与后端保持同一事实
前端位置来自同一 TopologySceneRuntime 的当前时刻计算,链路来自当前已提交 snapshot,损毁 ID 也来自该物理代次。SRv6 路径、HEFT 重算、Anycast 漂移和业务事件则来自真实节点、controller、ClickHouse 与 MinIO 证据,并携带同一非空 Run ID。
前端可以把连续位置动画与 60 秒链路时槽叠加显示,但不能:
- 根据画面距离自行补一条“看起来应该连通”的线;
- 因为页面没收到下一帧就关闭后端链路;
- 点击卫星反向命令控制器安装路由;
- 用伪造 300 点代替真实 Docker 节点。
16.28 从源码验证本章的阅读顺序
建议按因果顺序阅读:
configs/issue255-physical-scene-300.json:先看场景参数;scripts/physical_scene_provider.py:位置、LOS、匹配、接入、损毁和 link 字段;scripts/topology_slot_store.py:事务与不可变 snapshot;scripts/topology_scene_runtime.py:monotonic 时间、current/next;scripts/topology_slot_fabric.py、scripts/topology_snapshot_to_fabric.py和scripts/continuous_polar_fabric.py:物理代次激活;src/host_link_fabric.c:活动矩阵如何逐包生效;scripts/neighbor_hello_wire.py与neighbor_hello.py:真实邻居发现;scripts/sdn_node_agent.py与sdn_topology_module.py:上报、双向确认、本地 FIB。
读任何一条日志时都先问:它属于运动、物理图、节点观察、控制协议图还是 Linux applied状态?这一步通常比先调大超时更快找到真正边界。
17. 控制面到底控制什么
17.1 事实与命令的区别
Fact(事实)描述某组件已经观察到的状态,例如:
- 节点 17 实际收到节点 18 的 HELLO/ACK;
- 节点 20 当前上报 gray 算子存活;
- endpoint 233 当前被节点 42 本地接入服务观察到;
- 节点 20 CPU busy 为某个量化值。
Command(命令)要求另一个组件执行动作,例如“给节点 17 安装到节点 42 的 FIB”。
本项目控制器传播事实,不向节点发送单任务策略命令。节点收到全局事实后,只计算和安装自己的 FIB、Anycast 路由和本地任务 SR Policy。
17.2 为什么不是“控制器什么都做”
集中控制器拥有全局视图,不等于它必须拥有全部状态修改权。若控制器替 200 个节点执行所有 ip route:
- 某一个节点内核慢会占住控制器;
- 单节点失败会扩大成全局队列;
- 控制器必须维护每个节点的安装事务;
- 入口任务失败会变成远程控制协议失败;
- 节点无法根据本地 HELLO 快速切换自己的下一跳。
当前边界把失败限制在最小所有者:控制器维护全局事实,节点维护本地内核状态。
18. 四个控制器容器
控制器被拆为四个长期运行的容器,而不是一个全能进程。
18.1 access
access(接入模块)拥有节点控制附件上的会话和 UDP I/O。它负责:
- 接收节点 JOIN、邻接、端点和资源上报;
- 向已接入节点发送最新拓扑和端点快照;
- 跟踪每个节点自己的 ACK/STATUS;
- 统计控制字节和发送错误;
- 对拓扑/端点快照执行 latest-only 重发。
access 不运行 HEFT,不安装节点 FIB,不产生业务。
18.2 host
host(主机事实模块)维护:
- 已注册网络节点身份;
- 端点接入声明;
- 各节点已应用的拓扑代次;
- 各来源节点的资源事实。
它形成全局事实视图,但不进入任何节点 namespace 修改路由。
18.3 topology
topology(拓扑模块)接收节点邻居观察。只有一条边的两端都报告彼此时,边才进入 确认图。一侧 DOWN 立即删除;恢复要求双方重新确认。
当确认图变化时,topology 形成新的 generation。它不等待全部 200 节点同时出现;当前可见的部分图立即服务当前可达业务。
18.4 route
route(路由成本模块)计算控制器内部的网络成本视图,供资源事实和入口本地 HEFT 使用。当前成本是可达最短跳数乘 1000。
route 不下发 FIB 或 SR Policy。名字叫 route module,不代表它拥有节点 Linux route。
18.5 控制信息流
节点邻居上报 ─► access ─► topology ─► global topology generation
节点端点上报 ─► access ─► host     ─► endpoint ownership snapshot
节点资源上报 ─► access ─► host/route─► source-scoped resource facts

global facts ─► access ─► 每个已接入节点
19. 控制线格式与代次
19.1 固定 Header
节点到控制器的主线格式使用 9-byte 头:
type | node_id | flags | payload_length | generation | sequence
 1B      1B       1B         2B             2B          2B
type:消息类型;node_id:发送/接收网络节点,范围 1..255;flags:FULL、UP、OK 等有限标志;payload_length:payload 字节数;generation:全局快照版本;sequence:同一发送源的消息序号。
Sequence(序号)解决同一来源消息的新旧和重复;generation 标识一份全局事实版本。 二者不能互换。
19.2 主要消息
| 消息 | 方向 | 意义 |
|---|---|---|
JOIN | node→access | 节点接入控制面 |
LINK_DELTA/邻居快照 | node→access | 本节点观察的邻接变化 |
TOPOLOGY_UPDATE | access→node | 一份完整稀疏无向图 |
TOPOLOGY_STATUS | node→access | 本节点已计算并安装该代 FIB |
ENDPOINT_UPDATE | node→access | 本节点当前实际接入的端点集合 |
ENDPOINT_SNAPSHOT_UPDATE | access→node | 当前端点归属事实 |
ENDPOINT_SNAPSHOT_STATUS | node→access | 节点已接收应用端点快照 |
RESOURCE_UPDATE | node→access | 本节点 CPU、内存、算子和有效期 |
RESOURCE_FACT_UPDATE | access→node | 某来源节点的一条资源事实 |
控制协议中没有 DAG_REQUEST、COLOR_UPDATE 或 SR_POLICY_UPDATE。任务请求不去控制器。
19.3 Snapshot
Snapshot(快照)是某一代完整自洽的状态视图,不是逐行补丁。拓扑 snapshot 包含:
version | node_count | edge_count | sorted undirected edges
节点收到后先完整校验,再提交给 forwarding worker。不能读取一半边就开始安装 FIB。
19.4 Latest-only
Latest-only(只保留最新值)表示中间代可以被更新的事实取代。若节点还在计算 generation 12,而控制器已经产生 13、14、15,节点不必依次安装所有过期中间态;它在完成当前边界后处理最新完整代。
这不是丢失历史证据。不可变事件流保留真实状态转换;latest-only 只用于当前操作状态。
19.5 每节点独立背压
Backpressure(背压)是消费者来不及处理时限制生产或保留量的机制。access 对每个 节点最多保留一个未确认拓扑/端点快照;慢节点只对自己形成背压,不阻塞其他 199 节点。
同样,资源事实按来源独立更新。一个损毁节点的下行失败不进入无限重试队列;只有该节点后续新的有效资源上报,才重新启用向它分发资源事实。
20. 节点内部的并发边界
一个网络节点至少包含以下长期活动:
| 线程/进程 | 责任 | 明确不能做什么 |
|---|---|---|
| HELLO thread | 发送 HELLO、接收 ACK、维护 liveness | 不等待日志或 ip route |
| control receive thread | 收控制报文并校验快照 | 不直接修改 FIB |
| forwarding worker | 串行安装 FIB、uSID、Anycast 和 task policy | 不写同步业务日志 |
| resource sampler | 量化本地 CPU/内存/算子 inventory 并上报 | 不主动探测远端资源 |
| task ingress bridge | 验证 REQUEST 来源并交本地 planner | 不把任务转给控制器 |
| async event writer | 批量写 JSONL | 失败不能反压协议线程 |
| operator supervisor | 创建并守护本节点实际算子 | 不按单个任务临时起停算子 |
Liveness(存活性)表示对方是否仍通过协议活动被观察到。 Inventory(清单)表示本节点实际存在且存活的算子实例。
20.1 accepted 与 applied
节点必须区分:
- accepted snapshot:已经接收和校验;
- applied snapshot:已经由 forwarding worker 成功安装到本地内核。
任务规划只能使用 applied 事实。否则节点可能用 generation 15 的图计算策略,却仍用generation 14 的 FIB 转发,得到跨代组合错误。
20.2 为什么只有一个 forwarding worker
FIB、Anycast nexthop 和 task route 可能共同修改 Linux 路由状态。如果多个线程并发执行ip route replace,单个函数都正确仍可能产生顺序竞态。唯一 worker 提供清晰所有权:
事实线程提交状态
→ worker依次重算并安装
→ 成功后发布applied状态
这不是全局 barrier,只是单个节点内核配置的串行所有权。
21. 节点怎样形成自己的 FIB
21.1 从全局图到本地一行
节点 17 收到同一份全局图,但只计算“从 17 出发”的路由。节点 42 计算“从 42 出发”的路由。它们不互相复制 FIB。
节点为每个目的计算:
primary_next_hop
backup_next_hop(满足LFA时)
21.2 同一个目的节点需要哪些前缀
对每个可达网络节点 N,本地 FIB 协调四类前缀:
fd42:1::<N>/128         普通节点IPv6
fd42:2::<N>/128         物理/交付SID
fd42:3:<N>::/64         N拥有的具体算子SID locator
fd42:4:<N>::/64         N拥有的独立端点交付SID locator
它们共享到 N 的物理下一跳,但语义不同。
21.3 邻居故障快速切换
HELLO thread 观察直接邻居 DOWN 后,只向 forwarding worker 提交不可用邻居集合。worker对受影响目的从 primary 切换到合法 backup。它不等待下一份完整拓扑才处理入口第一跳。
下游故障不一定能被入口直接看到;相邻节点的报告最终形成新全局 generation,入口再基于新图重算任务。
22. 资源事实与端点事实
22.1 Resource Summary
Resource Summary(资源摘要)包含:
- instance:节点进程实例标识,重启后变化;
- cpu_logical:逻辑 CPU 数量;
- cpu_busy_milli:CPU 忙碌度,
0..1000; - memory_total/available:总内存和可用内存;
- operator_bitmap:当前存活算子位图;
- lifetime_seconds:这条事实的有效期。
Bitmap(位图)用一个整数的不同 bit 表示不同算子是否存在。统一镜像包含二进制, 但只有实际 inventory 中的存活进程才能置位并成为 HEFT 候选。
22.2 资源只来自节点上报
控制器不得 SSH、ping 或 RPC 主动探测节点 CPU 和算子。节点定期量化本地事实;数值不变时自然抑制重复上报;接收方按 lifetime 淘汰过期事实。
这保证“资源存活”的权威来源只有资源所有者,而不是控制器猜测。
22.3 Endpoint Ownership
Endpoint Ownership(端点归属)表示 endpoint 当前被哪个 access node 实际观察。 它是持续变化的事实,不是永久配置。
handover 期间可能短暂出现:
- 旧节点仍声明 endpoint;
- 新节点也已声明 endpoint;
- 某个瞬间没有节点声明 endpoint。
这些都必须保留为物理事实。控制器不使用固定等待或人为 owner 仲裁制造“永远唯一”。入口只等待当前任务涉及的目的事实,不让无关端点成为全网屏障。
22.4 本地正面事实优先
外部端侧从本地链路发送的合法 REQUEST,是入口看到的正面接入事实。控制器快照可帮助解析目的端,但不能因为全局快照暂时冲突就撤销源入口的本地任务。
只有同一入口自己的 HELLO/ACK 服务实际观察到 source detach,才撤销本地 task、Color、rule 和 policy。新入口只响应端侧自然重发的 REQUEST。