前五编已经建立普通 IPv6 FIB、逻辑/具体 SID、任务和算子实例。本编才第一次系统学习服务选择:先从普通路由理解“多个实例共享一个逻辑地址”,再观察 provider 怎样自然变化。第七编随后加入跨包状态,说明漂移的代价;第九编最后学习更复杂的全链联合选择。这样不会用尚未定义的图片窗口或调度公式反过来解释 Anycast。
40. 先从 Unicast、Multicast 和 Anycast 的区别开始
学习 Anycast 以前先比较三种交付方式:
| 方式 | 中文 | 一个包交给谁 |
|---|---|---|
| Unicast | 单播 | 一个明确地址对应的一个目的 |
| Multicast | 组播 | 加入同一组的一组接收者 |
| Anycast | 任播 | 多个实例共享一个地址,路由选择其中一个 |
Anycast 不会把同一个包复制给所有 provider。它仍是一条普通 IPv6 /128 路由,只是多个位置都能提供这个逻辑目的。哪一个实例收到包,由当前节点的 FIB 和下一跳决定。
41. 为什么计算服务需要逻辑地址
第五编已经区分 operator type(算子类型)与 operator instance(算子实例)。若调用者写:
fd42:3:14::100
它明确要求 node-20 上的 Gray,节点 20 不可达时这个地址不会自动变成 node-38。若调用者只要求“某个可达 Gray”,则使用逻辑服务 SID:
fd42:7::100
因此:
具体SID = 功能 + 物理实例位置
逻辑Anycast SID = 只有功能身份,位置交给路由选择
当前节点本地 Anycast FIB 覆盖五种图像服务:BNN Fire Filter、Gray、Tile Mean 2×2、Tile Blur 3×3 和 Edge。Fire Mask 与 Binary Fire Mask 仍有具体实例能力,但不属于当前Issue 243 逻辑 Anycast 图像链,不能仅凭“统一镜像里有七类算子”就虚构其 Anycast route。
42. Provider 事实从哪里来
Provider(提供者)是当前真实运行某个算子实例的网络节点。节点启动自己的算子以后, 把 operator bitmap、进程 instance、resource sequence 和 lifetime 作为事实上报。控制器只汇总这些节点事实,再把同一份资源视图传播给网络节点。
每个节点本地计算 Anycast 路由时只使用自己已经接收并应用的:
confirmed topology graph
+ operator provider bitmap
+ 本地HELLO观察到的直接邻居可用性
配置文件声称某节点“应该有 Gray”不等于该实例当前可用;事实过期、进程重启或节点不可达都必须自然改变候选集。控制器不进入容器探测,也不替节点选 provider。
43. 每个节点怎样计算 Primary 和 Backup
scripts/anycast_fib.py 从观察节点对当前双向图执行 BFS,为每个 provider 寻找经不同本地first hop 可达的确定性路径。候选按以下规则排序:
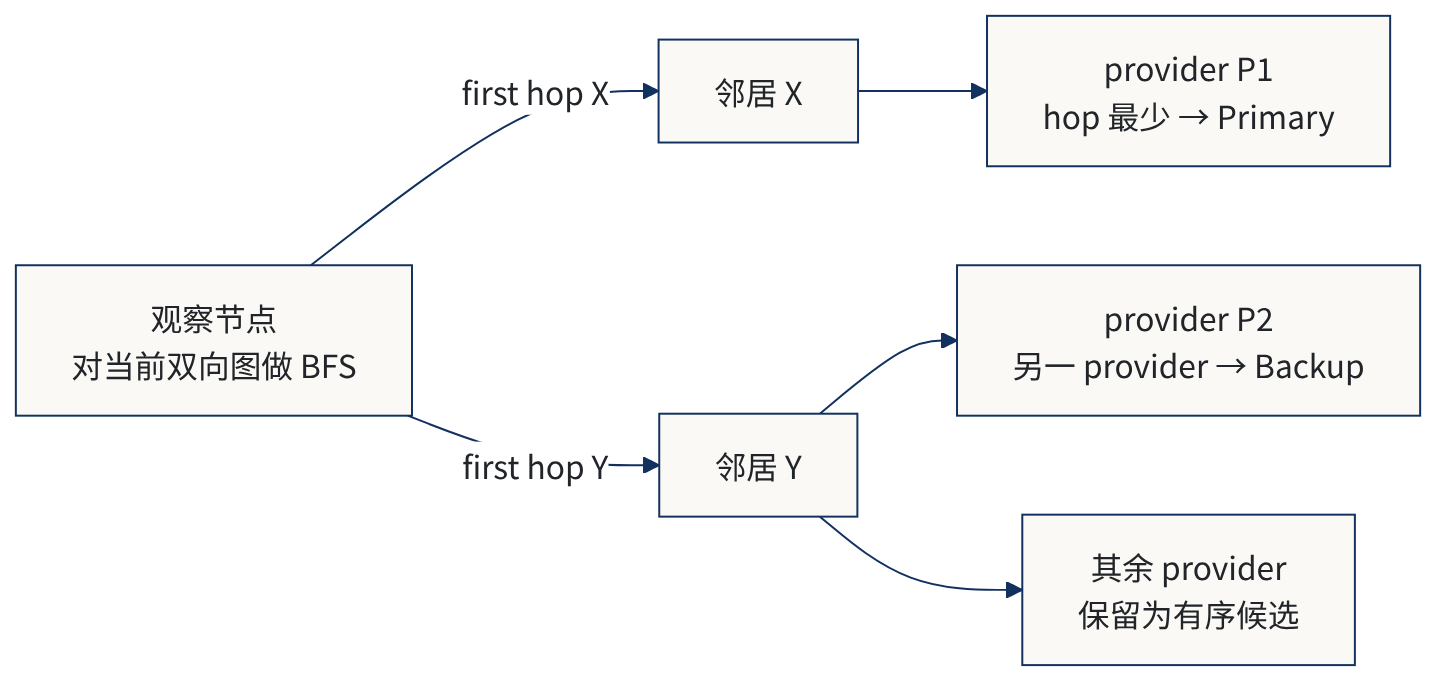
图 1 节点本地计算 Primary / Backup:hop 数最少者为 primary,backup 必须来自另一个 provider,并尽量换一个 first hop
- primary 先选 hop 数最少者;
- hop 数相同按 provider node ID 和完整 path 稳定排序;
- backup 必须来自另一个 provider;
- 有条件时优先选择与 primary 不同的 first hop;
- 其余 provider 继续保留为有序候选。
“不同 provider”避免把同一实例的另一条等价路径误称为实例冗余;“尽量不同 first hop”让直接邻居故障时更可能立即切换。它是一条通用、确定性的路由规则,不读取当前有哪些 task,更不按某次业务结果安排答案。
44. 逻辑服务怎样安装进 Linux FIB
每个逻辑 service SID 都有稳定的 Linux nexthop object 和一条普通 IPv6 /128 路由。初始化时nexthop 先指向 blackhole(黑洞),表示尚无合法 provider;节点得到事实后用一次 iproute2 batch 替换对应 nexthop:
远端provider:via fe80::<next-hop> dev 数据接口
本地provider:via 算子namespace网关 dev 本地算子veth
无provider:blackhole
路由本身保持稳定,活动 nexthop 对象改变。直接 HELLO 发现 primary first hop down 时,节点可从预计算候选中立即选择 backup,不等待控制器生成一份“正确答案”;之后的新全局拓扑再重建完整候选集。
45. Resilient 任务怎样使用 Anycast
Resilient Placement(弹性放置)把 DAG 中的算子类型编译成逻辑 SID 链。例如:
逻辑Gray SID → 逻辑Mean SID → 逻辑Edge SID → 最终交付SID
入口安装 task SR Policy 时不运行 HEFT,也不选择 node-20 或 node-38。包到达某个逻辑 SID 时,该位置的普通 IPv6 FIB 选择当前 provider。拓扑或实例变化只替换逻辑服务 nexthop,task_id、Color 和 SRH 服务顺序保持稳定。
这就是 routing-based placement(基于路由的放置):每项服务在到达时做局部路由选择。它与第九编的 HEFT 全链联合编排是两种不同模型,不能因为最终都得到某个 provider,就把Resilient 选择称为 HEFT 结果。
46. Provider 漂移为什么是自然现象
假设 node-17 当前到 Gray 的排序为:
primary = Gray@20, first hop 18
backup  = Gray@38, first hop 44
当 17 实际收不到 18 的 HELLO/ACK,或 Gray@20 事实过期,FIB 自然改选 Gray@38。已经发出的旧包可能到 20,新包到 38;没有任何组件把一个包复制给两个容器。
这种变化叫Provider Drift(提供者漂移)。对单包无状态算子,两个合规实例给出相同算法结果,漂移通常只造成路径变化。对需要跨包缓存的有状态算子,不同包落到不同实例会拆散窗口。第七编在定义 SPP 对象和 Tile 以后再精确解释这种损失,当前只保留因果链:
拓扑/实例事实变化 → 各节点本地FIB变化 → 后续包选择变化
47. Anycast 应该记录和展示哪些事实
节点对每个逻辑服务记录:
anycast_route_selected:从无路由变成选中 provider;anycast_route_changed:活动 provider 或 first hop 变化;anycast_route_withdrawn:没有合法 provider;anycast_candidates_changed:活动转发身份未变,但主 provider/下一跳或备provider/下一跳发生变化;- service SID、operator、primary、backup、candidate count 和 topology generation;
- 受影响 Resilient task 的稳定 nexthop 是否重新绑定。
第三顺位以后的候选路径仍由每个节点持续计算,并保存在 latest-only 状态中。它们没有改变当前内核 FIB,也没有改变立即可用的主备转发前沿,因此不为每次路径重算写一条永久事件。减少的是可重建的派生转录,不是资源、拓扑、故障或业务事实。
前端只能把这些真实 FIB 事件画成 Anycast 漂移,不能根据两颗卫星在画面上的距离猜 provider。排错时先问“该观察节点当时有哪些已应用 provider 事实和路径”,不能从目的端结果倒推出一条人为粘性规则。
47.1 第六编自测
- Anycast 与 Multicast 的核心差别是什么?
fd42:3:14::100和fd42:7::100分别表达什么?- 为什么每个节点会算出自己的 Anycast FIB,而不是控制器下发一个全网 provider?
- backup 为什么要求另一个 provider 并尽量使用不同 first hop?
- provider 变化为什么不需要替换 Resilient task 的 SRH?
- 同一个包会不会因为 Anycast 被复制给五个容器?