57. 编排问题到底在求什么
一条业务声明“先 Gray,再 Edge”,系统仍不知道应该选择哪个 Gray 实例和哪个 Edge 实例。不同选择会带来不同的:
- 网络传播与传输代价;
- 实例计算时间;
- 排队和资源竞争;
- 故障风险;
- 最终完成时间。
Orchestration(编排)就是把抽象计算步骤映射到具体可运行资源,并产生可执行路径。 本项目的 Exact 模式使用 HEFT 做这件事。
58. 异构是什么意思
Heterogeneous(异构)表示资源并不完全相同:
- 节点 CPU 逻辑核数不同;
- 当前 CPU busy 程度不同;
- 可用内存不同;
- 算子清单不同;
- 节点间跳数、带宽和可达性不同;
- 实例 lifetime 和故障状态不同。
如果所有节点和链路完全相同,随机挑选也可能表现相近;在异构环境里,放置选择才成为真正的优化问题。
59. DAG 的数学表示
设 DAG 为:
G = (V, E)
V是 stage 集合,每个 stage 是一项计算;E是依赖边集合,边(i,j)表示 j 必须等待 i 的输出;pred(i)是 i 的直接前驱集合;succ(i)是 i 的直接后继集合。
对每个 stage i:
P_i是能执行它的候选 processor 集合;w(i,p)是 i 放在候选 p 上的计算代价;c(i,j,p,q)是 i 在 p、j 在 q 时传输依赖数据的代价。
HEFT 论文把执行资源称为Processor(处理器)。在本项目中,实际调度资源是“某物理节点上的某个具体算子实例”;同一物理节点上的任务还共享节点可用时间轴。
60. HEFT 全称和基本思想
HEFT(Heterogeneous Earliest Finish Time,异构最早完成时间)是 Topcuoglu、 Hariri 和 Wu 提出的列表调度算法。它分两大阶段:
- Task Prioritizing Phase(任务优先级阶段):用 upward rank 给 DAG 节点排序;
- Processor Selection Phase(处理器选择阶段):按顺序把任务放到能最早完成的资源。
Heuristic(启发式)表示它用有效规则寻找优良解,但不保证对所有 NP-hard 调度实例都 得到数学全局最优解。HEFT 的优势是计算快、解释清楚,适合在线重算。
61. HEFT 第一阶段:平均代价
61.1 平均计算代价
stage i 的平均计算代价是它在全部可用候选上的计算时间平均:
               1
w_bar(i) = ----------- × Σ w(i,p)
            |P_i|        p∈P_i
Σ 读作“求和”,|P_i| 表示候选数量。
61.2 平均通信代价
依赖边 (i,j) 的平均通信代价,是所有可行候选组合上的通信时间平均:
c_bar(i,j) = average of c(i,j,p,q)
             over viable p ∈ P_i and q ∈ P_j
若两个 stage 落在同一物理节点,具体实现可把网络通信视为本地代价;若跨节点,则根据数据量、路径代价和链路速率估算。
平均值只用于计算优先级。真正放置某 stage 时,必须使用被选候选间的具体代价,不能继续用平均值代替。
62. HEFT 第一阶段:Upward Rank
Upward Rank(向上排序值)从 DAG 出口反向计算,估计“从当前 stage 开始直到任务结束”的 平均剩余关键路径长度。
对于一般 stage:
rank_u(i) = w_bar(i)
          + max [ c_bar(i,j) + rank_u(j) ]
            j∈succ(i)
若 i 没有后继,通常:
rank_u(i) = w_bar(i)
本项目还显式估算最后算子到目的端 sink 的通信时间,所以出口 stage 的 rank 包含平均 sink 代价。
max 的含义是:多个分支里,最长的平均剩余路径决定关键程度。rank 越高,越应优先调度。
HEFT 随后按 rank_u 降序生成 list(列表)。DAG 依赖保证后继不会在前驱结果尚不存在时实际开始。当前内置业务 DAG 是固定线性链,声明依赖顺序与 rank 优先顺序等价;代码仍计算并输出rank,作为代价证据和未来支持分支 DAG 的基础。
63. HEFT 第二阶段:EST 与 EFT
63.1 Processor Available Time
Processor Available Time(处理器可用时间)是候选物理节点完成此前已放置 stage 后,最早 何时还能接新工作。记为:
available(p)
本项目在物理节点层维护这条时间线,避免误以为同节点多个算子可以无限并行而没有 CPU 竞争。
63.2 Dependency Ready Time
对 stage i 的候选 p,每个前驱 j 必须先计算完成,再把输出传到 p:
ready(i,p) = max [ finish(j) + c(j,i,place(j),p) ]
             j∈pred(i)
若 i 是第一个 stage,ready time 来自入口把输入送到候选 p 的通信代价。
63.3 Earliest Start Time
EST(Earliest Start Time,最早开始时间)是资源可用与依赖到达两者中较晚的一个:
EST(i,p) = max(available(p), ready(i,p))
63.4 Earliest Finish Time
EFT(Earliest Finish Time,最早完成时间)为:
EFT(i,p) = EST(i,p) + w(i,p)
算法为 stage 枚举所有候选,选择 EFT 最小者。最后一个 stage 选择时还把它到 sink 的通信代价纳入比较,防止选中“算得很快却离目的端很远”的实例。
64. 本项目怎样估算计算时间
task DAG 为每个 stage 声明 cpu_cost_units。节点资源报告提供:
cpu_logical:逻辑 CPU 数量;busy_milli:繁忙比例的千分数,0 表示完全空闲,1000 表示没有剩余能力。
当前估算为:
compute_us = ceil(
    cpu_cost_units × 1,000,000,000
    ÷ [cpu_logical × (1000 - busy_milli)]
)
ceil 表示向上取整,us 表示 microsecond(微秒,百万分之一秒)。busy 越高,分母越小,估计时间越长;逻辑 CPU 越多,估计时间越短。
这是调度成本模型,不是物理 CPU 周期的完美预测。真正运行时间仍由事件时间戳观测,不能把模型预测当成已经发生的事实。
65. 本项目怎样估算通信时间
stage 输出声明 data_bytes。路径提供 cost_milli,链路提供 link_rate_bps:
comm_us = ceil(
    data_bytes × 8 × cost_milli × 1,000,000
    ÷ [1000 × link_rate_bps]
)
data_bytes × 8把 byte 换成 bit;bps是 bits per second,每秒 bit 数;cost_milli/1000表示路径成本倍数;- 默认未知速率按 1 Mbit/s 处理,而不是假设无限快。
当前控制面物理路径成本仍是:
cost_milli = hop_count × 1000
因此当前 HEFT 通信估算主要体现跳数、数据量和速率;它不能被描述为已经读取每条真实动态传播时延的“latency-aware(时延感知)”优化。AF_XDP 数据面仍独立应用真实配置的 rate、queue 和 delay。
66. 候选过滤先于优化
HEFT 只能在真实可运行候选上优化。一个实例成为候选,至少要满足:
- 资源报告未过 lifetime;
- 实例清单包含所需 operator type;
- CPU 剩余能力足够,
busy_milli < 1000; - 可用内存达到 stage 要求;
- 入口到实例、stage 之间以及最终到 sink 存在可接受路径;
- 不在本次 backup 计算的 excluded SID 集合中;
- 不依赖已被排除的链路或失效节点。
这一步叫Feasibility Filtering(可行性过滤)。没有候选时返回 no solution(无解)是正常算法结果,不是 HEFT 程序崩溃,也不应该伪造一个实例继续。
代码还对线性 DAG 进行 forward/backward viability(前向/后向可行性)过滤:只有既能由入口到达、又能经余下 stage 到 sink 的候选才保留。这样避免先选中一个局部很快、后面却无路可走的死端。
67. 一次完整手算
考虑线性 DAG:
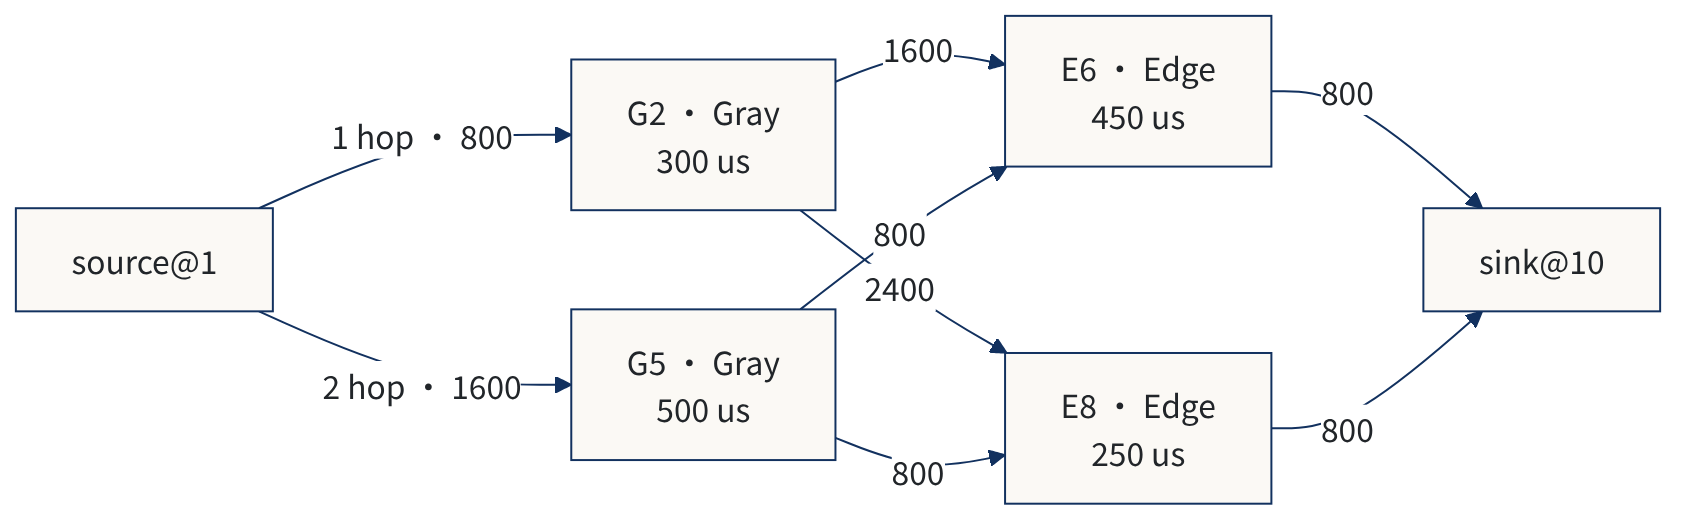
图 1 手算示例:线性 DAG、候选实例与计算 / 通信时间(每 hop 800 us)
source@1 → Gray → Edge → sink@10
为方便手算,假设每段数据都是 100 byte,链路速率 1 Mbit/s。每跨一个 hop 的传输时间是:
100 × 8 ÷ 1,000,000 second = 800 us
候选与计算时间:
| Stage | 候选 | 计算时间 |
|---|---|---|
| Gray | G2 | 300 us |
| Gray | G5 | 500 us |
| Edge | E6 | 450 us |
| Edge | E8 | 250 us |
跳数矩阵:
| 方向 | hop | 通信时间 |
|---|---|---|
| source1 → G2 | 1 | 800 us |
| source1 → G5 | 2 | 1600 us |
| G2 → E6 | 2 | 1600 us |
| G2 → E8 | 3 | 2400 us |
| G5 → E6 | 1 | 800 us |
| G5 → E8 | 1 | 800 us |
| E6 → sink10 | 1 | 800 us |
| E8 → sink10 | 1 | 800 us |
67.1 算平均代价
Gray 平均计算:
w_bar(Gray) = (300 + 500) / 2 = 400 us
Edge 平均计算:
w_bar(Edge) = (450 + 250) / 2 = 350 us
Gray 到 Edge 四种组合的平均通信:
c_bar(Gray,Edge)
= (1600 + 2400 + 800 + 800) / 4
= 1400 us
Edge 到 sink 平均为 800 us。
67.2 算 upward rank
出口 Edge:
rank_u(Edge) = 350 + 800 = 1150 us
Gray:
rank_u(Gray) = 400 + 1400 + 1150 = 2950 us
因此先放置 Gray,再放置 Edge,恰好也符合线性依赖顺序。
67.3 放置 Gray
假设两个候选起始都空闲:
G2: EST = 800,  EFT = 800 + 300 = 1100 us
G5: EST = 1600, EFT = 1600 + 500 = 2100 us
选择 G2,Gray 预计在 1100 us 完成。
67.4 放置 Edge
选择 E6:
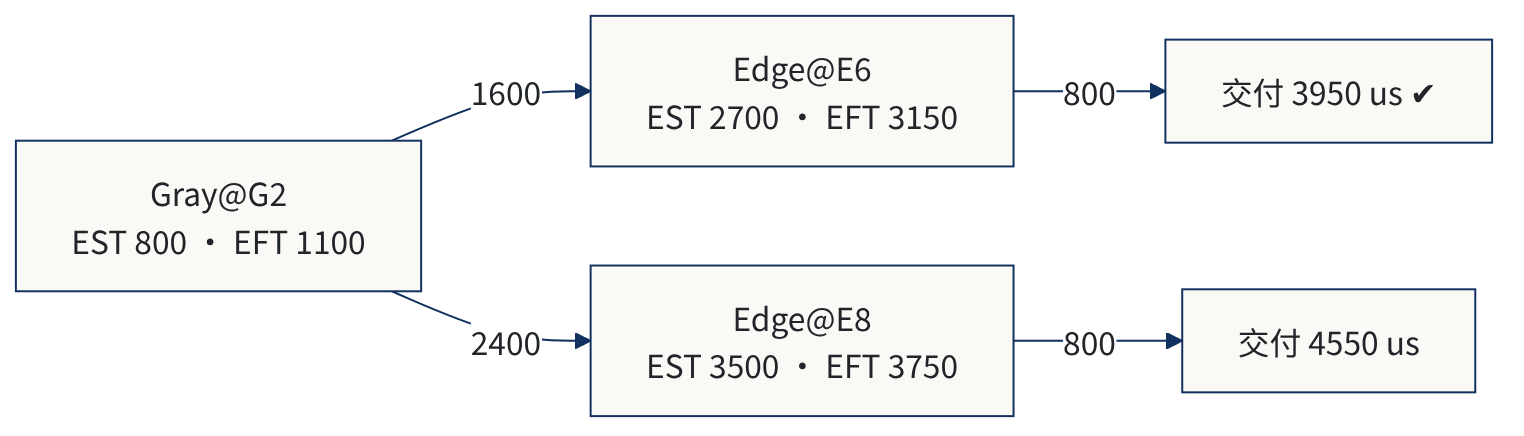
图 2 放置结果:E8 自身更快,但 E6 的完整完成时间更早,最终 makespan = 3950 us
dependency ready = 1100 + 1600 = 2700 us
EST(E6) = 2700 us
EFT(E6) = 2700 + 450 = 3150 us
加sink通信 = 3150 + 800 = 3950 us
选择 E8:
dependency ready = 1100 + 2400 = 3500 us
EST(E8) = 3500 us
EFT(E8) = 3500 + 250 = 3750 us
加sink通信 = 3750 + 800 = 4550 us
虽然 E8 自己计算更快,完整完成时间却更晚,所以选择 E6。最终放置为:
Gray@node-2 → Edge@node-6
predicted makespan = 3950 us
Makespan(总完工时间)是从任务开始到全部 stage 及最终交付完成的预计时间。
这个例子说明 HEFT 不是“永远选 CPU 最快的节点”,而是联合考虑入口、计算、stage 间通信和目的端交付。
68. 从 HEFT 结果到 SR Policy
HEFT 输出的是 placement:
Gray → concrete Gray SID at node-2
Edge → concrete Edge SID at node-6
策略构造器再把物理路径和具体算子 SID 拼成 segment list。例如概念上:
入口到node-2物理uSID
→ fd42:3:2::100
→ node-2到node-6物理uSID
→ fd42:3:6::200
→ node-6到目的端物理uSID
→ endpoint delivery SID
入口节点给 task 分配 Color,安装这条 SR Policy,成功后才发 READY。HEFT 本身不操作内核,控制器也不替节点安装策略;它们之间通过清楚的接口分工。
69. Primary 与 Backup
Primary(主策略)是正常使用的 HEFT 结果。为了得到有结构差异的 backup(备策略),系统:
- 先算 primary;
- 从备份拓扑中移除 primary 第一条物理边;
- 排除 primary 已经选择的具体算子 SID;
- 在剩余候选和路径上重新运行完整 HEFT。
这样 backup 不是把 primary 名字改成“backup”,而是在入口分离和算子实例上都尽量独立。
若剩余图没有完整可行链,backup 可以无解。系统应记录该事实,不能凭空捏造一条路径。任务是否允许只有 primary,由任务契约决定。
70. 动态重算
拓扑、资源、实例或 endpoint 事实发生变化时,入口本地 planner 检查现有 Exact placement 是否仍可用。若相关路径或实例失效,则在一份 immutable snapshot(不可变快照)上重跑 HEFT。
不可变的含义是:一次计算从头到尾看到同一版本输入;更新到达时生成下一快照,而不是在算法遍历一半时修改图。这样才能复现“这次决策为什么选了它”。
重算成功后,入口保持 task_id、Color、目的端和 placement mode 不变,用 route replace 原子替换内核策略。业务发生器不会由控制器重启,也不需要人为等待一个全局 barrier。
71. HEFT 耗时应该怎样记
必须把不同阶段分开:
故障真实发生
  ↓
节点发现/本地链路状态变化
  ↓
事实上报和控制面传播
  ↓
本地快照可用
  ↓
HEFT算法计算
  ↓
策略序列化和内核安装
  ↓
首个恢复业务包到达
decision_ns 只应围绕 HEFT 算法计算本身。ns 是 nanosecond(纳秒,十亿分之一秒)。故障发现、网络传播、消息排队、内核安装和首包恢复各有自己的时间戳。
若把整个闭环都记成“HEFT 时间”,就无法判断超过 100 ms 是算法慢、CPU 调度竞争、控制面积压,还是内核安装慢。超过某个观察阈值本身不是程序错误;应如实记录分布与分阶段证据。
72. CPU 调度竞争会怎样影响观测
在 300 节点环境中,许多容器、线程、AF_XDP 轮询和分析进程共享宿主 CPU。操作系统 scheduler(调度器)可能让 HEFT 线程暂时得不到运行时间。墙钟耗时因此包括:
实际CPU执行时间 + 等待被调度时间 + 锁/队列等待时间
判断 CPU 竞争不能只看“某次 decision 超过 100 ms”。至少要对比:
- 线程 CPU time 与 wall-clock time;
- run queue 长度和 CPU utilization(利用率);
- 同时发生的快照、日志和容器活动;
- 算法输入规模,如候选数、边数和 DAG 长度;
- install 阶段与 decision 阶段的独立耗时。
先分层观测,才能决定优化算法、减少无效快照、调整进程资源,还是根本无需修改。
73. HEFT 无解为什么正常
以下情况都可能产生无解:
- DAG 需要的某类算子当前没有存活实例;
- 实例存在但资源报告已过期;
- 入口到 stage 或最后 stage 到 sink 不可达;
- 10% 节点损毁切断了所有满足约束的链;
- primary 有解,但施加独立性约束后 backup 无解;
- 内存或 CPU 下限没有任何候选满足。
正确行为是返回结构化 REJECTED 或重算失败事件,保留原因和输入版本。不能“短路 HEFT 后算成功”,不能恢复控制器替端点制造业务,也不能延长超时掩盖不可行性。
74. 回看第六编:Resilient 为什么不是 HEFT
Resilient DAG 只声明逻辑 Anycast operator SID。每个节点的 FIB 根据当前路径选择 provider:
logical Gray → nearest/reachable Gray provider
logical Edge → nearest/reachable Edge provider
实例变化时,局部 FIB 更新,task SRH 不变。这是 routing-based placement(基于路由的放置),不是 HEFT。
两种模式各自回答不同问题:
| 维度 | Exact | Resilient |
|---|---|---|
| 算子地址 | 具体实例 SID | 逻辑 Anycast SID |
| 实例选择 | HEFT 全链联合选择 | 每个服务逐跳路由选择 |
| 状态变化 | 相关失效时重跑 HEFT | 更新逻辑服务 FIB |
| task SRH | 可能被原子替换 | 保持稳定 |
| 有状态漂移 | 固定实例期间较稳定 | provider 漂移可拆散窗口 |
不能因为 Resilient“也选择了一个 provider”,就把它称为 HEFT 结果。
75. HEFT 伪代码
下面是帮助理解的简化伪代码,不替代仓库实现:
function HEFT(dag, facts, ingress, sink, exclusions):
    candidates = filter_instances(dag, facts, exclusions)
    candidates = forward_backward_viability(candidates, ingress, sink)
    if any stage has no candidate:
        return NO_SOLUTION

    compute w_bar for every stage
    compute c_bar for every dependency
    compute rank_u from exits back to entries
    order = stages sorted by descending rank_u

    available_time[node] = 0
    placement = empty

    for stage in order:
        best = none
        for instance in candidates[stage]:
            ready = dependency_ready(stage, instance, placement)
            est = max(available_time[instance.node], ready)
            eft = est + compute_cost(stage, instance)
            score = eft
            if stage is an exit:
                score += communication_to_sink(instance, sink)
            choose the lowest score with deterministic tie-break

        if best is none:
            return NO_SOLUTION
        placement[stage] = best
        available_time[best.node] = best.eft

    return placement, ranks, costs, predicted_makespan
Tie-break(平局裁决)必须确定性:代价相等时按稳定字段排序,而不能依赖哈希表随机遍历 顺序,否则相同输入无法复现相同 placement。
76. 第九编自测
- HEFT 两个阶段分别做什么?
- upward rank 为什么从出口反向计算?
- EST 为什么是 resource available 与 dependency ready 的最大值?
- 手算例子中 E8 计算更快,为什么最终选择 E6?
- 候选过滤与优化选择有什么区别?
- primary 有解而 backup 无解,是否说明 HEFT 崩溃?
decision_ns为什么不能包含故障发现和内核安装?- Resilient 的 provider 选择为什么不叫 HEFT?